N8N15 października 20253 min czytania

Agentic RAG a klasyczny RAG: różnice i kiedy wybrać

Czym jest RAG, czym różni się agentic RAG od klasycznego, kiedy wystarczy prosty RAG, jak zbudować oba w n8n i jak ograniczyć halucynacje.

Patryk WlochCodeless
Co znajdziesz w tym artykule?

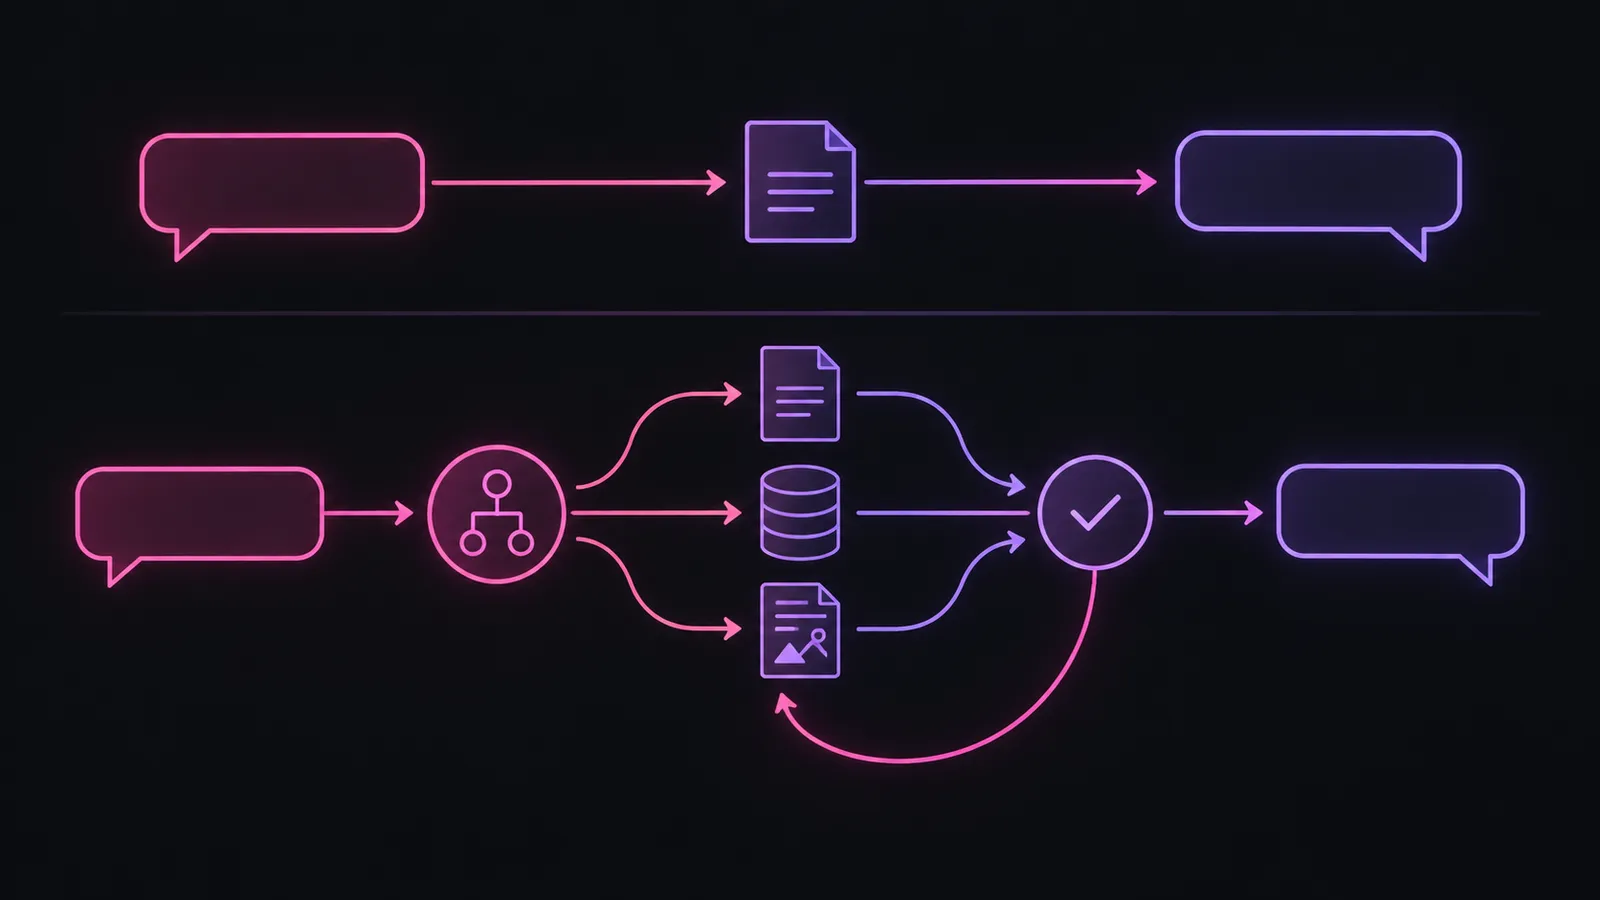
RAG (Retrieval-Augmented Generation) to sposób, w jaki model AI odpowiada na podstawie Twoich dokumentów: system najpierw wyszukuje pasujące fragmenty w bazie wiedzy, a potem przekazuje je modelowi jako kontekst do odpowiedzi. W klasycznym RAG ta ścieżka jest stała: jedno wyszukiwanie, jedna odpowiedź. W agentic RAG decyzje podejmuje agent AI: sam wybiera źródło (dokumenty, baza SQL, API), może przeformułować pytanie, wyszukać kilka razy i sprawdzić, czy odpowiedź jest kompletna. Agentic RAG lepiej radzi sobie ze złożonymi pytaniami, ale jest wolniejszy, droższy i trudniejszy w testowaniu.

Klasyczny RAG a agentic RAG

Klasyczny RAG Agentic RAG
Przebieg
Pytanie → wyszukiwanie → odpowiedź Agent planuje, wyszukuje, ocenia wynik, w razie potrzeby szuka ponownie
Źródła
Zwykle jedna baza wektorowa Kilka źródeł: dokumenty, bazy SQL, API, wyszukiwarka
Pytania
Proste, odpowiedź w jednym miejscu Złożone, wymagające połączenia kilku informacji
Czas i koszt
Szybki, tani, przewidywalny Kilka wywołań modelu, wyższy koszt i opóźnienie
Testowanie
Łatwe, stała ścieżka Trudniejsze, ścieżka zależy od decyzji agenta
Porównanie prostej ścieżki RAG i agenta, który planuje, szuka w kilku źródłach i sprawdza wynik

Kiedy wystarczy klasyczny RAG

Gdy pytania dotyczą jednej bazy wiedzy, a odpowiedź zwykle jest w jednym lub dwóch fragmentach: instrukcje, regulaminy, oferta, FAQ produktu. Tak działa większość chatbotów obsługi klienta. Jakość zależy tu głównie od przygotowania dokumentów: podziału na fragmenty, metadanych i aktualności treści.

Kiedy agentic RAG ma sens

  • Pytanie wymaga danych z kilku miejsc, np. „jaki jest status zamówień klienta X i czy mają opóźnienia?” (CRM + system zamówień + dokumenty dostaw).
  • Część danych jest w bazie SQL lub API, a nie w dokumentach.
  • Użytkownicy zadają pytania nieprecyzyjnie i trzeba je doprecyzować lub rozbić na kilka wyszukiwań.

Jak zbudować RAG w n8n

  1. Indeksowanie: workflow pobiera dokumenty, dzieli je na fragmenty, tworzy embeddingi i zapisuje w bazie wektorowej (np. Qdrant, PGVector).
  2. Klasyczny RAG: łańcuch Question and Answer Chain z retrieverem z tej bazy.
  3. Agentic RAG: węzeł AI Agent z kilkoma narzędziami: wyszukiwaniem w bazie wektorowej, zapytaniem SQL, wywołaniem API. Agent sam decyduje, które wywołać.
  4. Kontrola: odpowiedź zawiera źródła, a gdy agent nie znajdzie informacji, mówi to wprost.

Więcej o węzłach AI w artykule n8n i LangChain. Przykład wdrożenia: chatbot AI z RAG dla Ataszek.pl.

Jak ograniczyć halucynacje

  • Instrukcja: odpowiadaj tylko na podstawie znalezionych fragmentów, w przeciwnym razie powiedz „nie wiem”.
  • Pokazuj źródło każdej odpowiedzi, żeby użytkownik mógł je sprawdzić.
  • Utrzymuj aktualność bazy: automatyczna reindeksacja po zmianie dokumentu.
  • Testuj na zestawie pytań z oczekiwanymi odpowiedziami po każdej zmianie.

RAG w Twojej firmie

Budujemy asystentów i chatboty odpowiadające na podstawie dokumentów firmy, w wersji klasycznej i agentowej. Zobacz usługi chatbotów i wdrożenia AI albo umów bezpłatną konsultację.
Patryk Wloch

Codeless. Wdrażamy automatyzacje i AI w firmach. Piszemy o tym, co sprawdziło się u klientów.

Porozmawiajmy o Twoim procesie

Przykłady wdrożeń

Tak to wygląda u naszych klientów: konkretne procesy i liczby.

Obraz dekoracyjny

Automatyzacja FireTMS i Trello: Skrócenie czasu obsługi zleceń o 92% dzięki wdrożeniu AI w firmie transportowej

n8nFireTMSTrelloMicrosoft OutlookOpenRouterWhatsApp API

Dowiedz się, jak automatyzacja firmy transportowej PM Advise zintegrowała procesy między Outlook, FireTMS a Trello. Dzięki wykorzystaniu sztucznej inteligencji do analizy dokumentów PDF, wyeliminowaliśmy ręczne wprowadzanie danych, redukując czas obsługi zleceń o ponad 90%.

Zobacz case study
Obraz dekoracyjny

Chatbot AI dla Ataszek.pl – wdrożenie inteligentnego asystenta 24/7

N8NOnyx (RAG)OpenRouterCustom Connector

Wdrożenie AI/Chatbot: Inteligentny asystent oparty na RAG (Onyx) dla Ataszek.pl. Natychmiastowe odpowiedzi dla klientów i wsparcie sprzedaży.

Zobacz case study
Obraz dekoracyjny

Jak AI i automatyzacja n8n przyspieszyły kwalifikację leadów w Detailly 5-krotnie?

SlackOpenAISnov.ioCustom ScraperPipedriveN8N

Zobacz, jak dla Detailly wdrożyliśmy zaawansowany system automatyzacji pozyskiwania i kwalifikacji leadów. Połączyliśmy Snov.io, OpenAI i Pipedrive, eliminując manualne wprowadzanie danych i przyspieszając proces sprzedaży 5-krotnie.

Zobacz case study

Masz podobny problem? Porozmawiajmy.

30 minut z osobą, która potem to buduje. Po rozmowie wiesz, co da się zautomatyzować i ile to odda.

Umów 30 minut rozmowy

Słownik pojęć

TerminDefinicja
Agentic RAG - zaawansowany system sztucznej inteligencji łączący retrieval augmented generation z autonomicznymi agentami podejmującymi decyzje
RAG (Retrieval-Augmented Generation) - technika AI łącząca wyszukiwanie informacji z generowaniem odpowiedzi na ich podstawie
Halucynacje modeli językowych - zjawisko gdy AI generuje nieprawdziwe lub zmyślone informacje
Embedding - reprezentacja danych w postaci wektorów numerycznych umożliwiająca porównywanie podobieństwa
GraphRAG - zaawansowana technika RAG wykorzystująca grafy wiedzy do reprezentacji relacji między encjami
Retriever Router - mechanizm w agentic RAG odpowiedzialny za inteligentny wybór optymalnego źródła danych
Answer Critic - funkcja agentic RAG automatycznie weryfikująca kompletność i dokładność generowanych odpowiedzi

Pytania

Często zadawane pytania

Znajdź odpowiedzi na pytania związane z tym artykułem

Nie ma tu Twojego pytania?

Zadaj je na 30-minutowej rozmowie. Odpowiadamy konkretnie, na Waszym przykładzie.

Umów rozmowę →

RAG (Retrieval-Augmented Generation) to technika, w której system wyszukuje fragmenty dokumentów pasujące do pytania i przekazuje je modelowi AI jako kontekst odpowiedzi.