AIOps (AI for IT Operations) to wykorzystanie analizy danych i AI w zarządzaniu IT: grupowanie i filtrowanie alertów, wykrywanie anomalii w metrykach, szukanie przyczyny awarii w logach i automatyczne uruchamianie pierwszych kroków naprawczych. Celem jest mniej szumu dla zespołu i szybsza reakcja na realne problemy. AIOps nie powinien działać „na ślepo”: automatyczne naprawy wymagają sprawdzonych procedur, limitów i logów, a decyzje o zmianach w produkcji pozostają przy ludziach.
Co obejmuje AIOps
| Obszar | Co robi |
|---|---|
| Korelacja alertów | Łączy dziesiątki alertów z jednej awarii w jeden incydent |
| Wykrywanie anomalii | Zauważa nietypowy wzrost błędów lub czasu odpowiedzi przed progiem alarmowym |
| Analiza przyczyn | Wskazuje zmiany, wdrożenia i logi powiązane z problemem |
| Automatyczna reakcja | Uruchamia sprawdzone kroki: restart usługi, skalowanie, zgłoszenie |
| Podsumowania | AI opisuje incydent dla dyżurnego i raportu |
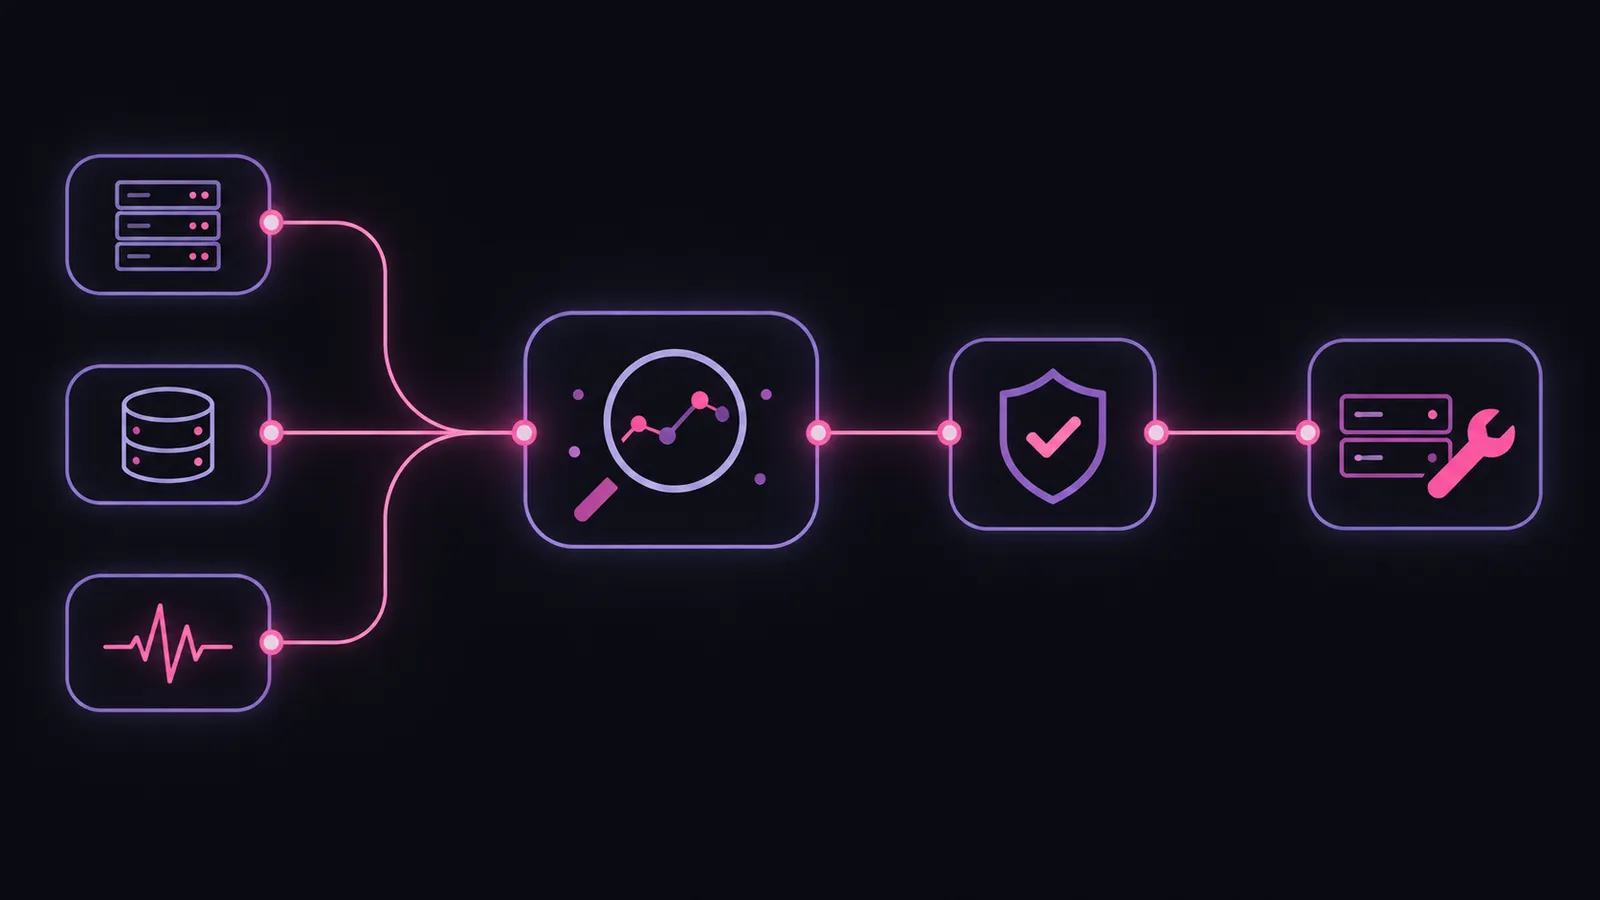
AIOps w mniejszej firmie
Duże platformy AIOps są drogie, ale podstawy można zbudować z monitoringu (np. Grafana, Zabbix, Prometheus) i n8n:
- Alert z monitoringu trafia do n8n.
- n8n sprawdza, czy podobny incydent jest już otwarty, i dołącza alert zamiast tworzyć nowy.
- Pobiera kontekst: ostatnie wdrożenia, metryki, fragment logów.
- Model AI pisze krótkie podsumowanie dla dyżurnego.
- Dla znanych problemów uruchamia procedurę, np. skalowanie, i loguje działanie.
Przykład: automatyczne skalowanie WMS z alertu Grafany do AWS EC2. Zobacz też automatyzacje Grafana.
Jak nie automatyzować na ślepo
- automatyczne naprawy tylko dla problemów z opisaną, sprawdzoną procedurą,
- limit powtórzeń: jeśli restart nie pomógł dwa razy, eskalacja do człowieka,
- każda akcja w logu z przyczyną i wynikiem,
- regularny przegląd: które automatyczne reakcje pomogły, a które maskowały problem.
Więcej w artykułach automatyzacja ITOps w n8n i monitorowanie bazy danych.
AIOps z Codeless
Zobacz usługę wdrożenia AI albo umów bezpłatną konsultację.