Pliki CSV do Snowflake ładujesz trzema głównymi metodami: przez interfejs Snowsight (szybkie ładowanie małych plików), poleceniem COPY INTO z plików umieszczonych w stage’u (wewnętrznym lub zewnętrznym, np. S3, Azure Blob, Google Cloud Storage) albo automatycznie przez Snowpipe, który ładuje nowe pliki, gdy pojawią się w stage’u. Do łączenia ładowania z procesami biznesowymi, np. pobrania pliku od dostawcy i powiadomienia zespołu, możesz użyć n8n lub narzędzia ETL.
Porównanie metod
| Metoda | Kiedy |
|---|---|
| Snowsight (interfejs) | Jednorazowe, małe pliki |
| PUT + COPY INTO | Ładowanie wsadowe, skrypty i harmonogramy |
| Snowpipe | Ciągłe ładowanie plików pojawiających się w stage’u |
| Narzędzie ETL / n8n | Pliki z zewnętrznych źródeł, połączenie z innymi krokami procesu |
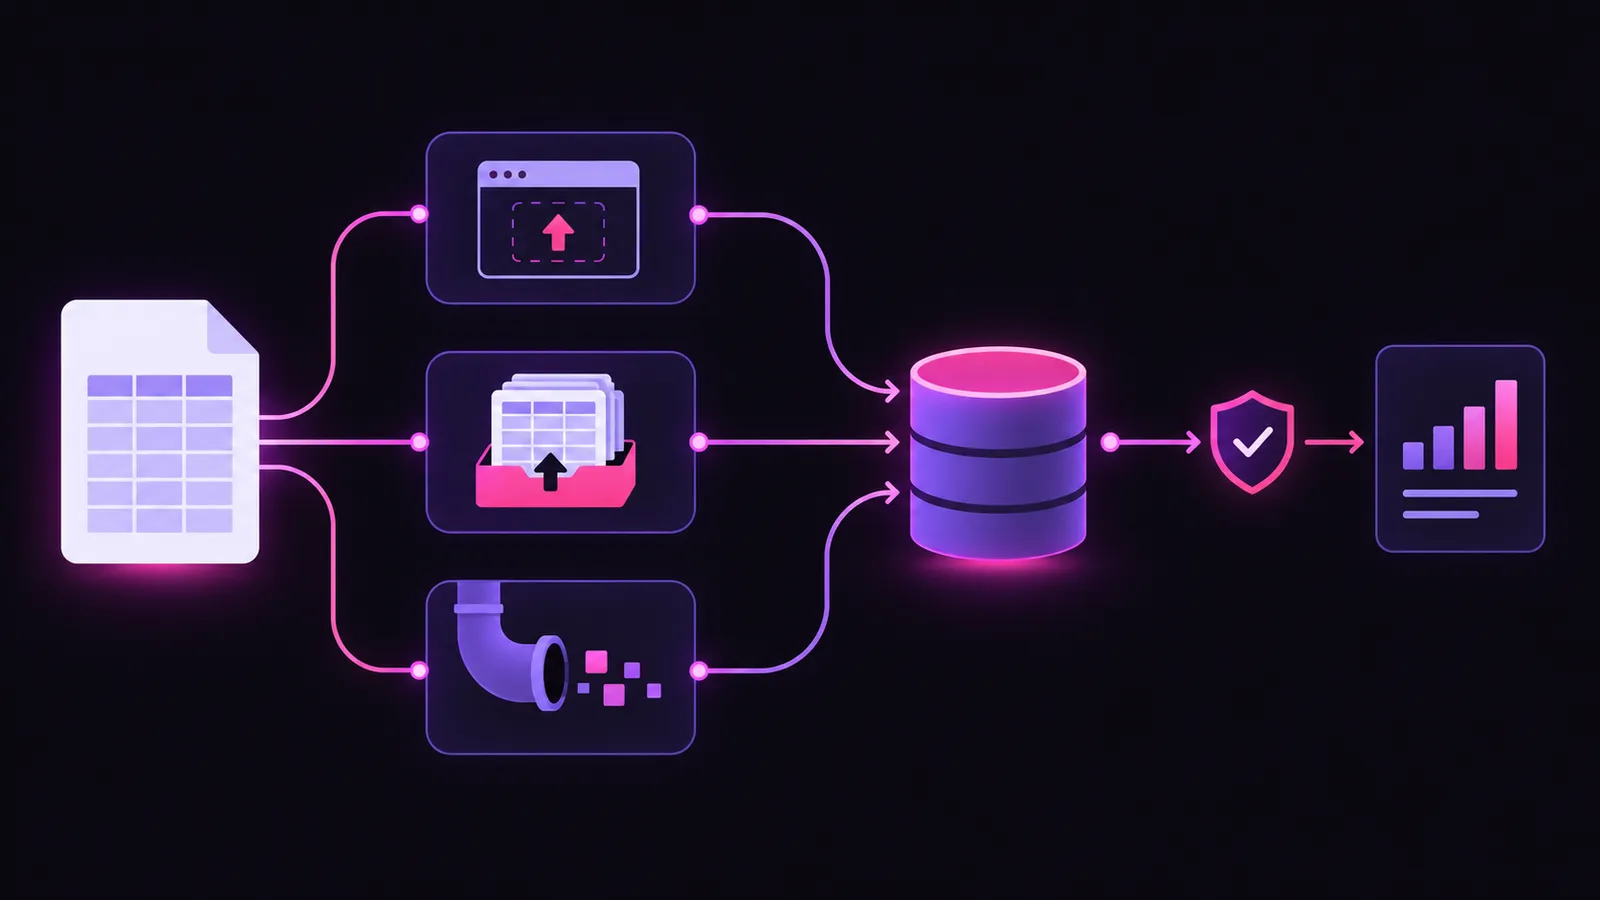
COPY INTO: podstawy
- Utwórz format pliku z separatorem, nagłówkiem i kodowaniem (FILE FORMAT).
- Umieść pliki w stage’u: wewnętrznym przez PUT albo zewnętrznym w chmurze.
- Wykonaj
COPY INTO tabela FROM @stage FILE_FORMAT = .... - Sprawdź błędy ładowania i odrzucone wiersze.
Snowflake pamięta, które pliki zostały już załadowane, co chroni przed podwójnym wczytaniem tych samych plików. Szczegóły opcji sprawdź w dokumentacji Snowflake.
Proces biznesowy wokół ładowania
Przykład: dostawca codziennie wysyła mailem plik ze sprzedażą. Workflow w n8n pobiera załącznik, zapisuje go w zewnętrznym stage’u (np. S3), uruchamia ładowanie lub czeka na Snowpipe, sprawdza liczbę wierszy i wysyła zespołowi potwierdzenie albo alert o błędach. Więcej o przenoszeniu danych w artykule narzędzia ETL, a o orkiestracji w tekście orkiestracja danych.
Na co uważać
- koszt obliczeń: ładuj partiami i wyłączaj nieużywane magazyny obliczeniowe,
- format dat i liczb w polskich plikach,
- uprawnienia: osobna rola do ładowania danych.
Dane i integracje z Codeless
Zobacz usługę automatyzacji procesów albo umów bezpłatną konsultację.